guides
在试点前如何评估用于 RAG 的向量数据库
一份基于文档的架构指南,用于为 RAG 试点向量或混合搜索数据层。MongoDB、Redis 和 Pinecone 的官方文档将权限过滤器和命名空间视为应用程序必须发送的查询时或设计时控制——省略过滤器就是无过滤搜索,而不是默认安全的索引。Azure AI Search 是一个托管搜索边界,而不是对已发布知识搜索指南的翻版。未测试延迟或召回率。
当向量数据库作为你控制的应用程序下的数据层时,它对检索增强生成很有用:嵌入、元数据、租户、过滤器,以及仍然需要引用或人工审核的生成步骤。它不是面向最终用户的知识搜索产品,也不仅仅因为向量位于托管服务中就“默认安全”。权限过滤是应用程序(或授权服务)必须在文档记录的时机应用的事情——在检索之前、在查询内部,或在候选结果返回之后。如果缺少这一步,相似的文本块可能会浮现给错误的用户。
这份基于文档的指南于 2026 年 11 月 10 日(亚洲/上海)审核。我们没有将公司文档加载到索引中、测量延迟或召回率,也没有测试生产访问控制系统。描述来自当天打开的 MongoDB Atlas Vector Search、Redis、Pinecone 和 Azure AI Search 官方页面。官方的召回率、成本或“超低延迟”表述是供应商文档,不是 AINav 基准测试。这是一份架构采购指南。它不是将专有数据放入公共或共享索引的教程。
RAG 数据层不是员工搜索助手
本次评测的目录核心是 MongoDB Atlas Vector Search 和 Redis Vector Search。MongoDB 官方文档将 $vectorSearch 描述为一个聚合阶段,可以在已索引的元数据字段上进行预过滤,并单独通过后续管道阶段(如 $match)对结果进行后过滤。Redis 官方文档描述了向量搜索可以“通过文本、数值、地理空间和标签元数据上的过滤来增强”,过滤器在 KNN 子句之前的查询中表达。
像 Pinecone 这样的专用向量数据库是该架构中的常见类别,下面引用了 Pinecone 官方文档关于租户和过滤器时机的内容。在官方目录名称 Pinecone 下存在一个实时 AINav 目录页面,因此 Pinecone 被包含在该真实目录 ID 的相关工具中。本次评测仍然不会编造超出已打开官方页面的功能或价格。Azure AI Search 在目录中,但被视为一个边界:微软官方文档描述了一个托管云搜索服务,可以运行经典索引搜索和代理检索,包括你仍然需要配置的企业访问控制功能。如果任务是面向员工的知识助手,请从已发布的指南 How to Evaluate Enterprise AI Knowledge Search Before You Buy 开始,而不是在这里重新进行那项采购。
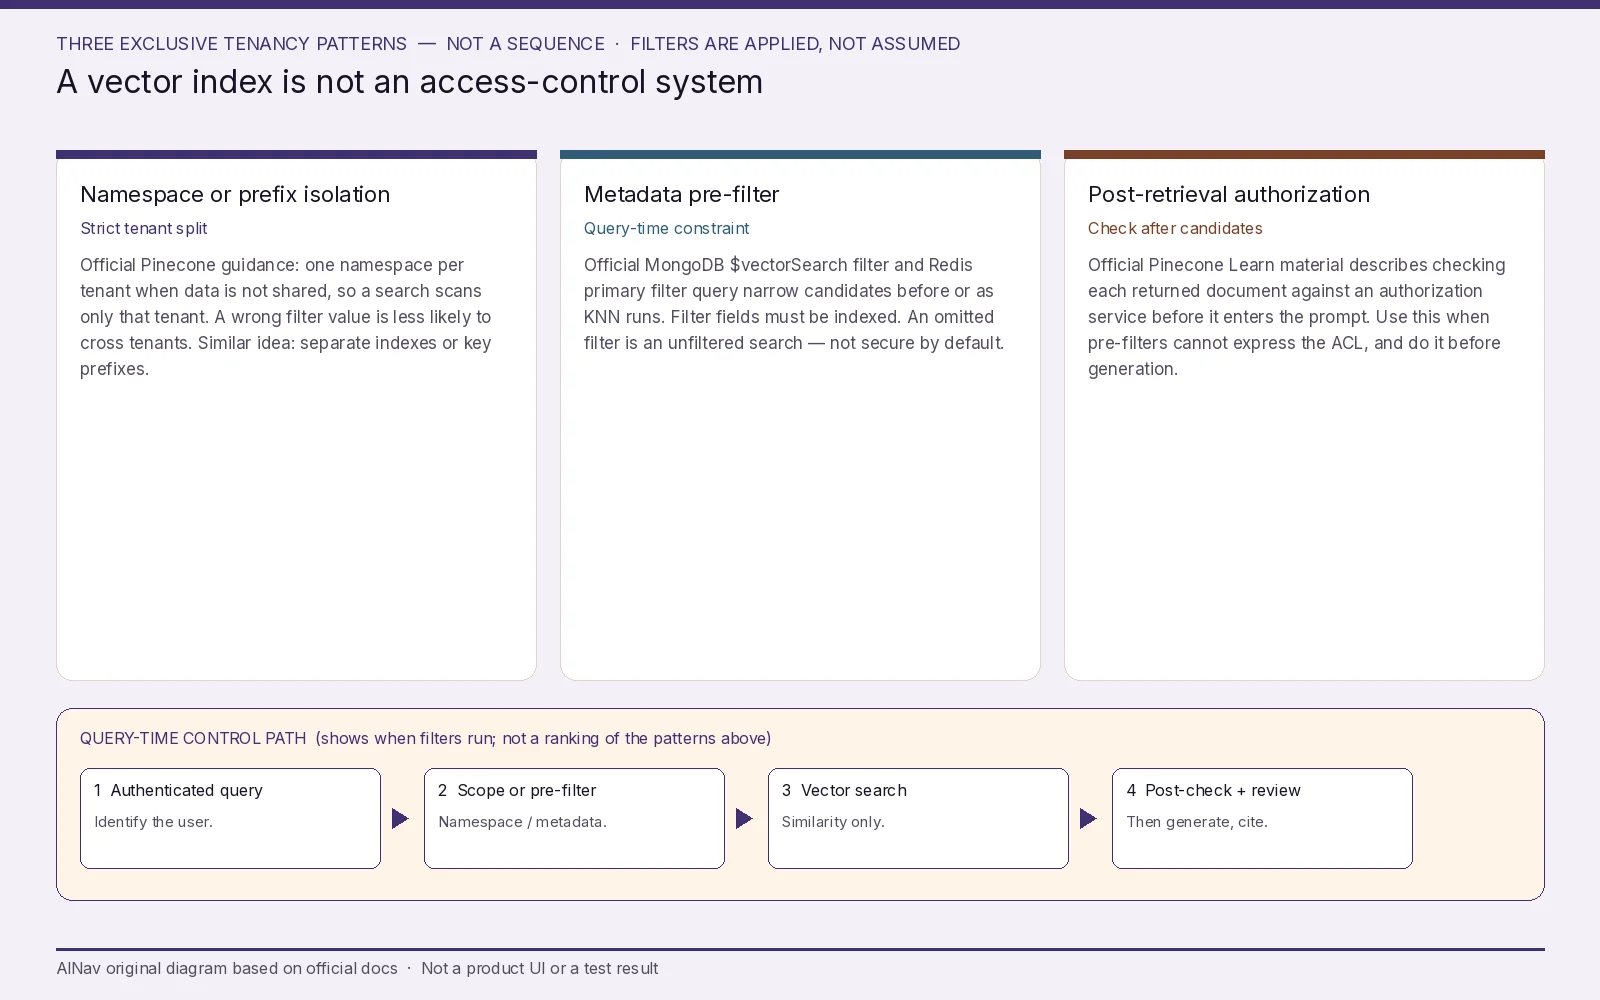
AINav 基于官方文档的原创示意图。来源:MongoDB $vectorSearch 过滤、Redis 向量搜索过滤器、Pinecone:多租户设计、带访问控制的 RAG。不是官方截图或测试结果。
过滤器在你发送时运行——索引不会凭空创造你的 ACL
官方供应商文档在一个演示中容易忽略的点上达成一致:相似性搜索和授权是不同的步骤。
MongoDB 官方文档说,你可以通过在已索引为 filter 类型的字段上提供 filter 表达式来进行预过滤,并且预过滤“确保在 MongoDB Vector Search 遍历 HNSW 图之前消除文档”。你也可以在 $vectorSearch 之后使用支持的管道阶段进行后过滤。官方文本指出,过滤查询通常比等效的无过滤查询慢,预过滤可能过于严格,并且如果你省略过滤器,搜索不会限制在某个租户或权限集内。Automated Embedding 被记录为预览功能,官方文档称不应在生产中使用。官方指南还警告 returnStoredSource 可能因复制延迟而返回过时数据。这些都不是默认安全保证;它是你必须设计、索引和测试的查询契约。
Redis 官方文档将主过滤查询放在 KNN 子句之前,例如标签或数值范围,并在不需要过滤器时使用 *。如果你用 * 查询,官方语法执行的是无过滤的最近邻搜索。Redis 记录了混合执行模式(批处理与临时暴力搜索)作为过滤搜索的延迟和准确性权衡,而不是访问控制系统。键上的前缀可以限制哪些记录被索引,但这仍然是应用程序的设计选择。
Pinecone 官方文档建议当每个租户的数据完全分离时,每个租户使用一个命名空间,因为搜索随后只扫描该命名空间,并且因为隔离“降低了应用程序错误搜索错误租户数据的风险(例如,通过传递不正确的过滤器值)”。官方文档还描述了数据共享时的元数据过滤器,并警告不要使用大型的单个用户 ID 的 $in 列表(包括一个记录的运算符限制)。一篇 Pinecone Learn 文章介绍了使用外部权限系统的预过滤和后过滤授权:查找允许的 ID 并将其作为元数据过滤器传递,或在检索后检查每个返回的文档。同一篇文章直白地说明了风险:如果用户对数据有不同的访问权限,RAG 管道必须强制执行这些边界;你不应该信任系统“自动做正确的事”。官方 Pinecone RBAC(在有记录的地方)管理对组织、项目和数据平面资源的访问——它不是查询中逐文档授权的替代品。
Azure AI Search 官方文档列出了 Microsoft Entra ID、Private Link、文档级访问控制和基于角色的访问等企业功能,并且还记录了一些来源的“安全过滤器变通方法”。官方产品语言中的“权限感知”是一种需要配置的能力,包括从支持的来源继承,而不是跳过设计审查的理由。
失败条件:嵌入在没有租户或 ACL 元数据的情况下被更新插入;查询在没有过滤器且没有命名空间的情况下发出;元数据拼写错误搜索了错误的租户;后过滤器在模型已经看到未授权文本块之后运行;删除或保留没有文档记录;或者假设托管搜索服务在没有文档记录设置的情况下强制执行你的文件共享权限。
基于官方行为而非延迟声明选择租户模式
Pinecone 官方指南是一个有用的类别映射,即使你在 MongoDB 或 Redis 中实现相同的想法:当数据不共享时,在单独的命名空间(或等效的索引/键前缀)中隔离租户;当共享时,使用组级元数据过滤器;如果官方限制和成本模型惩罚该模式,不要发布枚举数千个用户 ID 的过滤器。MongoDB 官方文档补充说,预过滤器必须索引为过滤器字段,并且 ANN 与精确最近邻搜索是召回率和延迟的权衡,你需要调整(例如使用 numCandidates),而不是安全控制。Redis 官方文档同样将 FLAT、HNSW 和其他索引类型区分为准确性对规模的选择。
不要为这些产品中的任何一个编造每秒查询数或毫秒数。在供应商自己的页面上确认当前官方定价和区域选项;集群、搜索节点和令牌费用(包括 MongoDB Automated Embedding,按令牌计费)因部署和区域而异,因此此处省略硬价格。
故意让生成步骤保持无聊。官方知识搜索和 RAG 文章,包括 Azure 的接地语言和 Pinecone Learn 授权演练,都假设检索到的文本只是上下文。在答案作为业务事实展示之前,要求引用或人工审核。该要求属于应用程序,而不是索引标志。
一个从不从生产语料库开始的试点
使用非生产项目、一次性索引或命名空间,以及已经公开或虚构的文档。在租户键、过滤器字段和删除行为被写下来之前,不要更新插入出口管制、个人或客户数据。然后检查六件事:
- 任务匹配。RAG 数据层、员工知识助手,或你已经在运营的应用程序搜索——选择一个官方任务。
- 过滤器时机。在跟踪或查询日志中显示授权是作为预过滤器、元数据或命名空间约束、后过滤器,还是某种组合发生。如果这些都没有触发,查询就不是权限感知的。
- 租户。对于严格分离,优先使用命名空间或索引隔离;当需要共享时使用组元数据;故意测试错误租户查询。
- 索引契约。确认过滤器字段确实被索引,并且对于最终用户流量,无过滤查询在应用程序中被拒绝。
- 生命周期。记录更新延迟、删除或墓碑行为以及保留。MongoDB 官方关于延迟的存储源语言提醒要测试新鲜度。
- 生成步骤审查。在任何人根据答案采取行动之前,要求引用或人工检查。这不是将私人文件倾倒到共享或公共索引的许可。
如果未授权文档可以到达提示,如果删除不明确,或者如果你邀请的产品是你误认为是向量数据层的最终用户搜索助手,请停止试点,或将语料库排除在外。
这次采购适合谁,谁应该另寻他处
本次评估适用于平台工程师和应用 AI 负责人,他们必须在将公司文档置于应用程序之后之前选择向量或混合搜索数据层。
它不是员工知识搜索的对比评测,不是延迟基准测试,也不是将专有数据加载到公共服务中的说明。
如果用户需要一个权限感知的公司搜索助手,请使用已发布的企业知识搜索指南,包括在 Azure AI Search 已经是组织标准的地方使用它。
常见问题
为什么 Pinecone 在相关工具中? 本次评测确认了 Pinecone 的实时 AINav 目录页面(目录 H1:Pinecone)。Pinecone 官方文档已经第一手打开以了解命名空间和过滤器模式,因此使用了该真实目录 ID。功能仍然来自那些官方页面,而不是目录 FAQ。
如果我们传递元数据过滤器,我们是否默认安全? 不。官方文档将过滤器和命名空间描述为应用程序必须正确发送的查询时(或设计时)控制。省略过滤器就是无过滤搜索。
我们应该在检索之前还是之后过滤? MongoDB、Redis 和 Pinecone 的官方材料都记录了预过滤器(或命名空间范围)和后过滤器或检索后检查。更安全的采购问题是某个文档记录的授权步骤是否在未授权文本进入提示之前发生,而不是某个供应商“是否安全”。
我们可以使用已有的云搜索服务而不是专用向量存储吗? 有时可以。Azure AI Search 官方页面描述了向量、混合和权限相关功能。将该路径作为它本来的托管搜索服务来评估,除非那才是实际任务,否则不要重做知识搜索文章。