OCR
$1.00USD / 前 5,000 次之后每 1,000 次事务
用于从文档文件中提取文本的光学字符识别。每月前 5,000 次事务免费。
- 每月前 5,000 次事务免费
- 超出免费额度后每 1,000 次事务 1.00 美元
- 处理扫描文档、移动端上传文件和 PDF
- 预训练 OCR 支持多种语言
AI 文档与PDF工具
产品概览
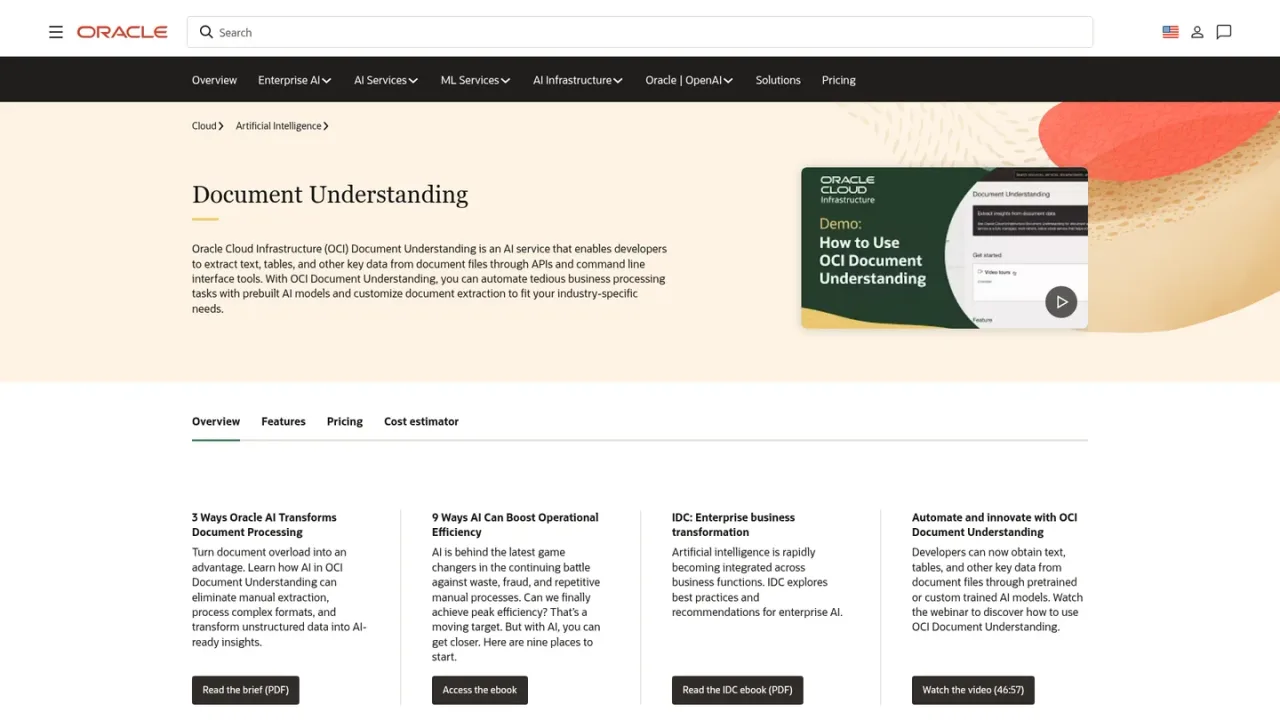
OCI Document Understanding 是 Oracle Cloud Infrastructure 的一项 AI 服务,面向需要将文档文件转换为结构化数据的开发者。它使用光学字符识别和其他预训练模型,从扫描文档、移动端上传文件、PDF、发票、收据、护照、驾照和健康保险 ID 卡中提取文本、表格和键值对,并将文档分类为发票、收据或简历等类别。预训练 OCR 和键值模型支持多种语言。团队还可以通过 OCI 控制台使用自己的数据训练、评估、部署和分析自定义模型,但该功能仅限有限可用。该服务通过 REST API、Python 和 Java SDK 或 OCI 命令行调用,结果可以 JSON 格式存储在 OCI Object Storage 中,并与其他 OCI 服务集成。定价为按需付费,每月有免费事务额度,超出后按单位收费。
从 OCI Object Storage 输入存储桶中选择文件,或从计算机上传本地文件。
使用预训练模型自动提取文本、表格、键值对和文档分类。
在 OCI 控制台中上传、标注并训练自定义模型,使提取适配你的数据或用例;此功能仅限有限可用。
将结果以 JSON 格式保存到 OCI Object Storage 输出存储桶,并与其他 OCI 服务(如 Oracle APEX 和 OCI Digital Assistant)集成。
通过提取发票和收据数据,自动化应付账款和费用处理
文档分析:将文档信息提取到 Oracle Autonomous Data Warehouse,并在 Oracle Analytics Cloud 中可视化
文档流程自动化:在 Web 应用中预填字段,或在 OCI Process Automation 中触发业务流程和人工审核步骤
通过文档分类增强搜索和检索
通过从护照和驾照等身份文件中提取信息,实现客户入职
它处理扫描文档、移动端上传文件和 PDF,包括旋转、倾斜或带阴影的页面。它还处理发票、收据、护照、驾照和健康保险 ID 卡。
预训练 OCR 和键值对模型支持阿拉伯语、中文、荷兰语、英语、法语、德语、希伯来语、日语、葡萄牙语、俄语、西班牙语和乌克兰语。
通过 REST API、包括 Python 和 Java 在内的多种 SDK,或 OCI 命令行。
可以。你可以在 OCI 控制台中上传、标注并训练用于键值对和文档分类的自定义模型,然后评估、部署和分析它们。此功能仅限有限可用。
结果以 JSON 格式存储在 OCI Object Storage 输出存储桶中,并可与 Oracle APEX 和 OCI Digital Assistant 等其他 OCI 服务集成。
定价为按需付费,按每 1,000 次事务或每训练小时计费。每个订单项都包含每月前 5,000 次事务的免费额度,自定义训练则为前 15 个训练小时,超出后收费。
Oracle 表示,模型不会为训练、调试或其他目的存储任何数据。
Oracle 提供免费试用,以及包含演示文档和你自己的文档的研讨会。
按需付费定价,以美元计。每个 Document Understanding 订单项都包含每月前 5,000 次事务(自定义训练则为前 15 个训练小时)的免费额度;仅超出这些额度后才收费。提供免费试用。
用于从文档文件中提取文本的光学字符识别。每月前 5,000 次事务免费。
使用预训练模型提取文档属性。每月前 5,000 次事务免费。
使用预训练模型从文档中提取关键数据。每月前 5,000 次事务免费。
使用自定义训练模型提取文档属性。每月前 5,000 次事务免费。
使用自定义训练模型提取键值。每月前 5,000 次事务免费。
使用自己的数据训练自定义模型。前 15 个训练小时免费。
用户评价
暂无评论。