guides
购买前如何评估 AI 体验分析工具
一份面向数字体验团队的基于文档的指南:在生产环境采集前配置合法依据、同意和掩码,然后判断 Contentsquare AI 和 Fullstory 的洞察是否可被重建。未安装任何实时标签,也未测量转化提升。
体验分析工具会以可预测的顺序出问题。团队启用会话回放来“看看用户做了什么”,然后在标签已经上线后才请法务为采集背书。本核心集中两家供应商的官方文档指向相反的顺序:先确定合法依据、配置同意和掩码,然后才开启生产采集。
本基于文档的指南于 2026 年 11 月 22 日(亚洲/上海)审阅。我们没有在真实网站上安装跟踪标签、观看真实访客会话或测量转化提升。描述来自当天打开的官方产品、帮助和开发者页面。未声称或测试任何提升百分比。这不是法律建议;隐私或法律顾问审查仍需将官方控制项映射到适用于你的法律。
在生产采集前配置同意和掩码
Contentsquare AI 和 Fullstory 都销售这样一幅图景:自动采集的数字行为,加上对其进行总结的 AI。只有当该采集合法且可重建时,购买才成立。
Contentsquare 的官方帮助文章你对个人数据收集的责任对角色说得很直白。你的组织是数据控制者,决定为何以及如何收集个人数据;Contentsquare 是处理者。你必须在收集之前定义所需的数据类别。“你负责确定合法依据。”并且,在需要同意的情况下:“应设置 cookie 横幅,以便在激活 Contentsquare 收集之前配置同意管理流程。”同一篇文章告诉你,在启用新的收集功能之前配置掩码,审查 URL、页面内容和自定义属性,并且在测试时不要使用真实个人数据。如果之后出现意外的个人数据,文档记录的路径是停止进一步收集、掩码或禁用来源,并联系 Contentsquare 和你的隐私团队——而不是一边继续采集一边“回头再处理”同意。
Fullstory 的官方控制项很容易被误读为“默认隐私意味着你可以先开启采集”。文档并不是这么说的。默认隐私在所有套餐中可用并由管理员配置,其设计目的是“除非被明确列入允许采集的安全名单,否则不会采集任何文本或将其发送到用户浏览器之外。”掩码在设备上进行;被排除和掩码的内容“永远不会离开用户设备”。这降低了将原始文本发送到 Fullstory 服务器的风险。但它本身并不创造合法依据,也不意味着每个元素都会一直保留到访客选择加入。
在 Fullstory 要求对选定元素获得明确同意的情况下,官方用户同意开发者指南说得很具体:配置为“在用户同意后采集数据”的 HTML 元素,只有在 FS('setIdentity', { consent: true }) 之后才会被采集。将同意设为 false 会停止采集这些元素。默认隐私还记录了与同意相关的 CSS 类,包括 .fs-unmask-with-consent。换句话说,同意是一条配置好的采集规则,而不是事后补上的说明信。如果你的市场要求在此类录制之前获得同意或选择加入,请将你的同意界面接入这些官方控制项,并且不要在未同意的流量上启用生产回放,同时“以后再调”。
因此,本文坚持的购买顺序是:合法依据和通知,然后同意和掩码规则,然后遵守这些规则的生产采集,然后 AI 洞察,然后是一个能够打开底层会话或图表并提出异议的人。
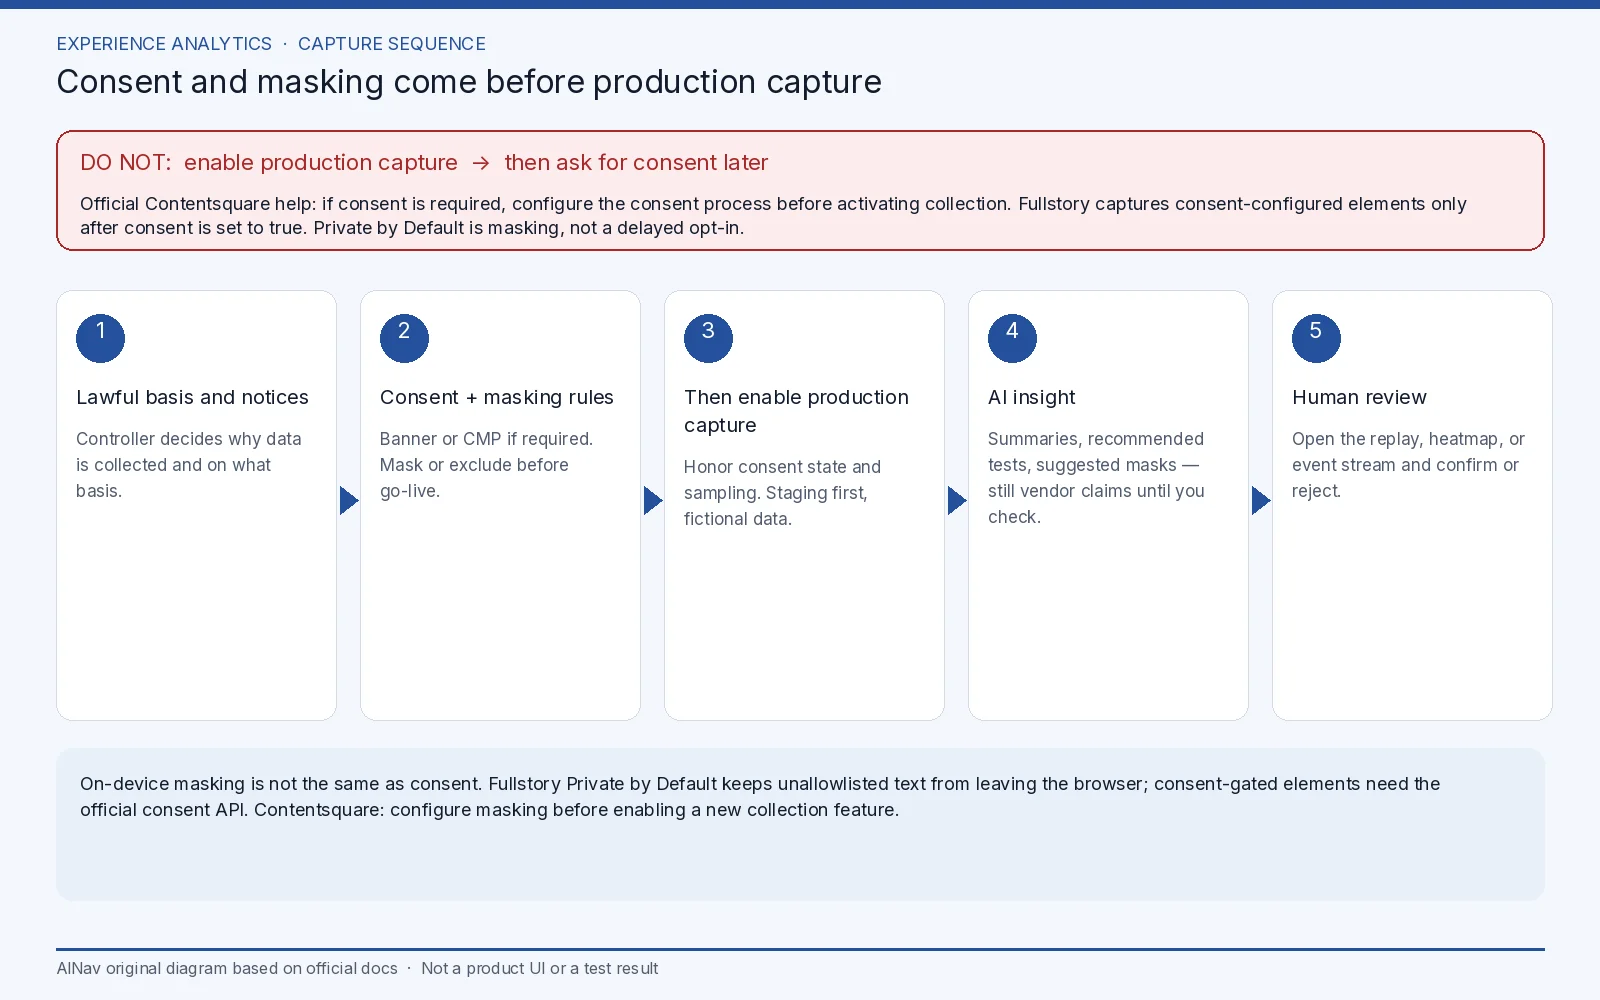
AINav 基于官方文档制作的原创示意图。来源:Contentsquare 客户责任、Contentsquare AI、Fullstory 默认隐私、Fullstory 用户同意。不是官方截图或测试结果。
AI 层实际声称了什么
Contentsquare 的官方 AI 能力页面将 Sense 和 Analyst 描述为能够发现问题、推荐测试、总结分区、热图、错误和旅程,并与平台对话的工具。同一处还描述了掩码能力:Sense 可以建议在会话回放中隐藏个人数据,由人批准或拒绝该建议。还提供映射辅助,使团队不必手动标记每个页面。该页面的 FAQ 指出,Contentsquare 使用预训练的第三方模型,并且“你的客户数据不会被用于训练这些第三方模型。”这是供应商关于第三方训练的声明,不是关于不处理任何数据的笼统声明,也不能替代上述控制者职责。关于挽回转化或“无需你动手”进行分析的营销语言,不是本次审查中测量到的结果。
Fullstory 的官方产品语言,包括默认隐私中记录的采集模型,都围绕从脚本被允许采集的事件中重建体验。AI 摘要的可信度只取决于其下方的采集规则。如果表单字段、账户文本或支付流程被过度取消掩码,你得到的是隐私事件,而不是更好的洞察。如果一切都排除,你可能有一个合法的设计,但产品无法回答你购买它所要回答的问题。文档记录的三选一——排除、掩码或取消掩码——才是实际的配置工作;对于 2021 年 11 月 10 日或之后创建的账户,表单隐私会自动掩码或排除常见表单元素。预览和范围规则的存在,是为了让管理员在将更改推送给最终用户之前先在自己身上测试。
本文审阅的两套官方资料都没有发布本文可以依赖的公开、普遍适用的标价。请在供应商报价中确认当前打包、回放采样和 AI 计划权益。不要将案例研究中的转化提升数字当作你自己的数字导入商业论证。
将本次购买与相邻类别区分开
这不是销售智能购买,也不是通用分析助手购买。如果任务是销售团队的账户研究或对话智能,请参阅购买前如何评估 AI 销售智能工具。如果任务是向数据仓库和 BI 模型提问,请参阅购买前如何评估 AI 分析助手。站内个性化引擎是不同的购买者和不同的法律足迹;它不在本核心集中。
从暂存标签开始的购买检查
使用暂存站点和虚构用户数据。在同意、通知和掩码经过审查之前,不要将试用标签指向生产流量。然后检查五件事:
- 合法依据。写下你将依赖同意还是其他依据,并确认供应商的官方控制项能够表达该选择。对于 Contentsquare,官方帮助说在需要同意时,应在激活收集之前配置同意流程。对于 Fullstory,确认哪些元素需要同意 API,哪些只是被掩码。
- 上线前掩码。Contentsquare 告诉你在启用新的收集功能之前配置掩码。Fullstory 告诉你最严格的重叠规则胜出。用虚构数据测试。
- 可重建的洞察。选择三个已知的暂存旅程。让 AI 总结它们,然后打开底层回放、热图或事件流,看看审查者能否确认或拒绝该总结。
- 采样和保留。官方页面笼统地描述了采样配额和产品定义的保留期;获取将适用于你合同的数字。对你从未录制的会话进行总结不是发现。
- 训练和子处理者。记录 Contentsquare 关于客户数据不用于训练其第三方模型的官方声明,并向 Fullstory 索取当前等效声明和数据处理条款(如果尚未在你的协议中)。
如果供应商无法展示符合你法律建议的采集前同意路径,如果无法在暂存页面上证明掩码,如果 AI 输出无法追溯到人类可以检查的会话或指标,或者如果概念验证需要先有生产流量,请停止购买。
本次购买适合谁,谁应该另寻他处
本评估面向需要旅程摩擦和回放、并愿意接受官方隐私文档所述实施工作的数字体验、UX 研究和产品分析负责人。
它不适合想要保证转化提升的团队、购买联系人数据的销售组织,或无法为同意和掩码审查提供资源的组织。如果你无法完成该审查,留在当前分析栈是保守的决定。
常见问题
我们可以现在开启回放,以后再添加同意横幅吗? 这正是官方 Contentsquare 帮助在需要同意时告诉你不要使用的顺序:在激活收集之前配置同意流程。Fullstory 的同意 API 同样只在同意设为 true 后才采集配置为同意控制的元素。不要将“默认隐私”视为跳过该步骤的许可。
默认隐私是否意味着在用户选择加入之前没有数据离开浏览器? 不是。它意味着除非列入允许名单,否则文本被掩码,并且被排除或掩码的内容不会发送到 Fullstory。根据你配置的规则,仍可能采集允许的数据或交互数据。受同意控制的元素是单独的、明确的设置。
Contentsquare 是否用我们的会话数据训练基础模型? 官方 AI FAQ 说 Contentsquare 使用预训练的第三方模型,并且不使用客户数据训练这些第三方模型。就任何其他处理或训练问题确认当前 DPA。
AI 摘要会取代观看会话吗? 官方页面将摘要呈现为一种确定检查优先级的方式。本次审查未测试摘要准确性。请保持人工参与。