guides
在部署 AI 本地化 TMS 平台之前如何评估
一份基于文档的翻译管理系统上线指南:键、翻译记忆库和语言专家审校是与 MT 引擎不同的采购项。RWS Language Weaver 官方页面描述了模型、Cloud、Edge 和连接器——这是一个边界,而不是第三个 TMS。自动确认的记忆匹配和引擎回退已写入官方帮助文档。未进行质量测试。
需要为软件字符串建立记录系统的本地化经理,买的不是一个粘贴式翻译框。工作是键、项目、翻译记忆库、供应商或语言专家工作流,以及回到仓库或 CMS 的路径。机器翻译引擎,即便是企业级引擎,也位于该系统旁边。把这两种采购混在一起,通常表现为文件永远无法重新进入产品,或者“AI 翻译”的文案因为 100% 记忆匹配被自动确认而上线。
这份基于文档的指南于 2026 年 11 月 10 日(亚洲/上海)审阅。我们没有运行本地化项目、给翻译质量打分或测试连接器。描述来自当天打开的 Lokalise、Smartcat 和 RWS Language Weaver 官方页面。接受率、基准和时间节省数字是供应商声明,不是 AINav 测试。
明确任务:TMS、MT 引擎,还是媒体工作流
翻译管理系统保存源键或片段,应用翻译记忆库和术语表,路由工作并导出。这是本文的核心集合:Lokalise AI 和 Smartcat。
机器翻译引擎通过 API、门户或本地设备翻译文本。RWS 官方页面将 Language Weaver 呈现为企业 AI 翻译:Language Weaver Pro 和 Fast 模型、Cloud API 和门户,以及防火墙后的 Language Weaver Edge,外加连接现有系统的 Connector Hub。这是一个适合附加到 TMS 的引擎。它本身不是键和工作流 TMS,因此 Language Weaver 在本文中是一个边界,而不是相关工具列表中的第三个 TMS。
粘贴式或文档 MT,包括 DeepL 类工具,已在如何在你订阅前评估 AI 翻译工具中涵盖。字幕工作流又是另一种交付物;参见如何在你付费前评估 AI 字幕翻译工具。口语声轨或配音又是另一项工作,本文不评分。
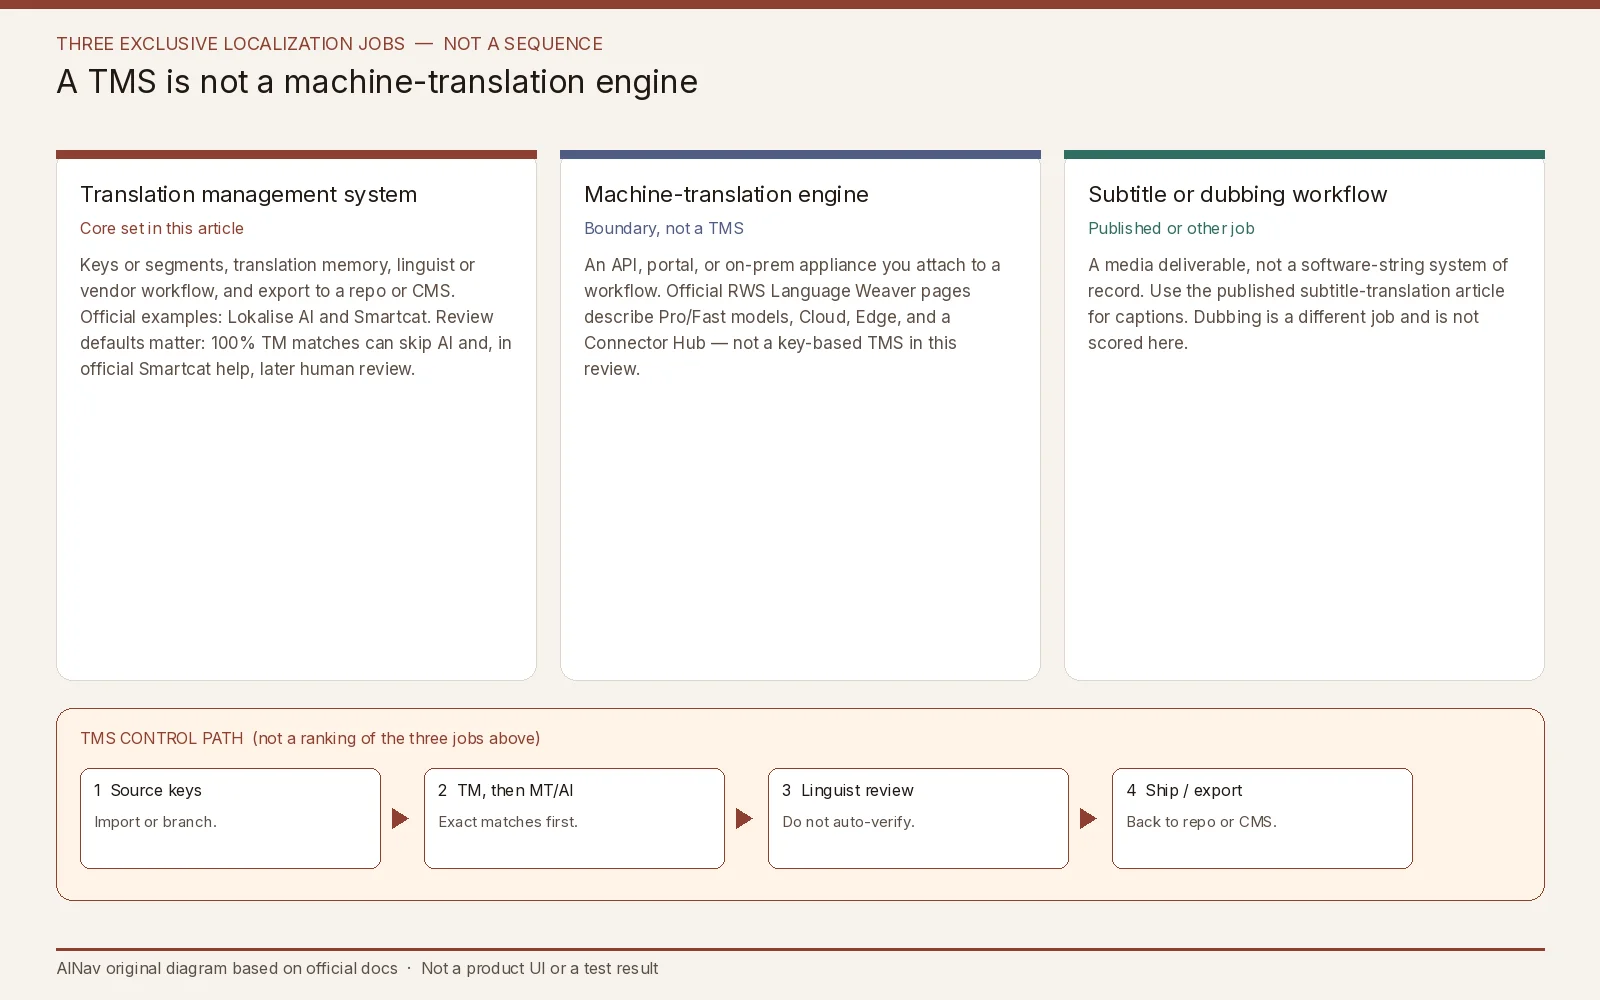
AINav 基于官方文档制作的原创示意图。来源:Lokalise AI Translations、Lokalise AI FAQ、Lokalise AI and ML Statement、Smartcat AI Translation Overview、RWS Language Weaver。不是官方截图或测试结果。
Lokalise:键、任务和两种不同的字数计量
Lokalise 官方帮助将 AI Translations 描述为 TMS 内的自动翻译任务,而不是独立的聊天框。键可以锁定直到任务完成。已经在另一个进行中任务里的键不能添加到新任务,直到你等待或将其移除,而已完成的键不能拉回。如果团队没有剩余的 Pro AI 字数,官方文档说你不能创建 AI Translations 任务。这些是上线失败,不是脚注。
任务本身的官方选项很具体。此处审阅的帮助中默认启用的“应用 100% 翻译记忆库匹配”会自动填充精确 TM 命中,不将这些片段发送给 AI,也不消耗 AI 字数。如果你取消任务,来自记忆的翻译不会消耗 AI 字数。“将翻译标记为已验证”如果你开启,会将 AI 输出标记为已验证——这是一个设置,不是质量测试,对于面向客户的 UI 来说是一个糟糕的默认值。“将 AI 执行的翻译保存到翻译记忆库”决定明天的匹配是否是昨天的机器输出。对于分段项目,默认只翻译空片段;重新翻译现有文案需要显式选项,且 100% TM 匹配仍然优先。
Lokalise 计量不止一种权益。官方 FAQ 语言区分 Standard AI/MT 翻译字数、Pro AI 翻译字数和已处理字数。首次填充空目标可能同时消耗 AI 配额和已处理字数;在不更改基础语言的情况下重新翻译现有目标内容仍可能计入 AI 配额而不消耗已处理字数。独立 AI LQA 消耗 Pro AI 字数但不消耗已处理字数。这些是不同的 SKU,不是官方价格冲突。此处省略硬性标价;请阅读你所在周期和地区的当前官方计划表。
上下文和审校有文档记录的限制。官方帮助告诉你不要用 2,000 字符的任务说明字段替代风格指南或术语表。键上的字符限制会触发使用替代模型的自动重试,最多两次尝试,以符合限制。区域代码很重要:官方示例说通用“葡萄牙语”可能输出巴西葡萄牙语,除非项目语言是 pt_PT。质量评分和 AI 检查因产品线而异(Lokalise Expert 可以分配 0–100 分;Vantage 使用严重性标签而不给数字)。官方文档仍建议对重要或专业内容进行人工审校。供应商数字如审校者“接受率”或与参考的精确匹配率是声明,不是我们运行的测试。
数据路径记录在 Lokalise 的 AI 和机器学习声明(最后更新于 2026 年 9 月)以及 AI FAQ 中。客户内容在推理时传递给第三方 LLM,不用于训练这些提供商;Lokalise 可能使用内容改进其自身内部模型,除非客户通过 AI 附录选择退出。自定义 AI 配置文件在推理时检索客户自己的 TM,不跨客户共享。FAQ 中的官方提供商说明包括 OpenAI 为滥用监控保留 30 天和 Anthropic 零保留——请重新检查实时子处理者列表,因为这些政策可能变化。
Smartcat:自动确认记忆,然后是有文档记录的回退
Smartcat 官方帮助(2026 年 10 月 13 日更新)描述了平台内的六步 AI 翻译路径:分割文件、查找已审校翻译、将未匹配片段发送到配置的 AI 引擎、运行 QA 检查、可选修复术语表错误,以及在仍有严重错误时回退。该路径是内含引擎的 TMS 工作流,这就是 Smartcat 属于本文核心集合的原因。这也是同一供应商在已发布的翻译工具文章中作为 MT 示例出现的原因:本次评估关注记录系统和审校默认值,而不是重做那个五支柱 MT 清单。
失败条件已写明。默认情况下,精确的已审校翻译匹配会自动应用、确认,并在你之后分配人工审校者时排除在范围之外。当记忆可信时这节省返工,如果不可信,它会悄悄发布糟糕的记忆条目。没有这些匹配的片段经过可配置的引擎路由。官方 QA 检查查找缺失标签、错误数字、标点、大小写和大幅长度波动。通过基于 OpenAI 的修正进行术语表术语修复适用于非 LLM 引擎;官方文本说 LLM 引擎被“信任”处理术语表术语,这是供应商假设,不是测试。如果片段仍有严重错误,如缺失格式或引擎响应失败,Smartcat“自动使用 Google NMT 作为可靠备份重新运行翻译”。官方帮助说未来的配置文件设置可能让你选择或禁用该回退——在依赖它之前确认实时控制。
官方上下文限制也很重要。AI 翻译代理接收封闭提示:语言、源文本、术语表和禁用术语,以及 TM 模糊匹配。片段评论、内容类型元数据和参考图像显示给人工编辑,但不传入 AI 提示。字符限制在生成后通过将输出送回缩短来执行。片段被批处理到模型的上下文窗口中,因此措辞可以在批次内保持一致,但在长文件的批次之间仍会漂移。
从一次性键开始的上线检查
使用虚构产品和一小部分键或脱敏文件,而不是生产字符串冻结。然后检查六件事:
- 任务匹配。如果你只需要一个粘贴式 MT 框,你在已发布的翻译工具文章中。如果你需要一个引擎位于现有 TMS 后面,Language Weaver 的官方 Cloud、Edge 和连接器路径就是那个任务,默认不是 Lokalise 或 Smartcat 的替代品。
- 记忆默认值。谁可以将 AI 输出写入 TM?100% 匹配是否同时跳过 AI 和人工审校?
- 权益。将 Pro AI 或 Smartcat 字数计量与已处理字数或席位分开,以及月度与年度计费分开。
- 区域和限制。确认区域代码以及字符串超过字符限制或引擎失败时会发生什么(Lokalise 重试;Smartcat 的文档回退是 Google NMT)。
- 人工审校。不要仅仅因为供应商分数看起来高,就在面向客户或受监管文案上启用“标记为已验证”或跳过审校。
- 数据路径。了解哪些 LLM 提供商看到推理内容,你是否已选择退出内部模型训练,以及哪里实际需要 Edge 或本地部署。
如果 AI 输出可以在没有指定审校者的情况下发布,如果自动确认的记忆无法审计,如果配额使正常发布不可预测,或者如果你实际需要的产品是 MT API,请停止上线。
这次采购适合谁,谁应该另寻他处
本次评估适用于需要具有文档化 AI 任务、记忆和审校的 TMS 的本地化和产品运营团队。
它不是 DeepL 重做,不是字幕或配音比拼,也不是 Language Weaver 质量竞赛。官方 Language Weaver 与其他 MT 系统对比的基准语言是供应商或赞助评估,不是 AINav 结果。
常见问题
Language Weaver 因为处于同一目录类别就是 TMS 吗? RWS 官方页面描述模型、Cloud API 和门户、防火墙后的 Edge,以及连接现有系统的连接器。将其视为 MT 引擎,除非当前官方页面记录了与 Lokalise 或 Smartcat 相当的键级 TMS 工作流。
100% 翻译记忆库匹配还会被审校吗? 在 Smartcat 官方帮助中,精确的已审校匹配默认自动确认并排除在后续审校分配之外。在 Lokalise 官方帮助中,100% 匹配在不消耗 AI 字数的情况下应用。在上线前审阅该默认值。
Pro AI 字数与已处理字数相同吗? Lokalise 官方文档说它们相关但不相同。在预测发布前计算两者。
我们可以在 AI 质量评分后跳过语言专家审校吗? Lokalise 官方文档仍建议对重要内容进行人工审校。评分或 QA 检查是路由信号,不是发布决定。